
Por MA Nautilius
Durante años, una de las respuestas más comunes al problema de calidad de información en un CRM ha sido convertir ciertos campos en obligatorios. Si la empresa necesitaba conocer el siguiente paso de una oportunidad, se hacía obligatorio el campo “Próximo paso”; si necesitaba entender por qué se perdían negocios, se exigía un “Motivo de pérdida”; si quería mejorar su segmentación, se obligaba a capturar industria, tamaño, origen o cualquier otra variable considerada relevante.
La lógica era razonable. Si una persona no puede avanzar mientras falte determinada información, el sistema termina acumulando menos espacios vacíos. Plataformas como Zoho CRM permiten precisamente definir campos obligatorios y establecer validaciones durante los procesos comerciales; además de exigir la presencia del dato, las reglas pueden impedir, por ejemplo, que un descuento supere cierto porcentaje o que una fecha de cierre exceda determinada condición. Fuente: Zoho CRM.
El problema comienza cuando confundimos ese control con calidad de información.
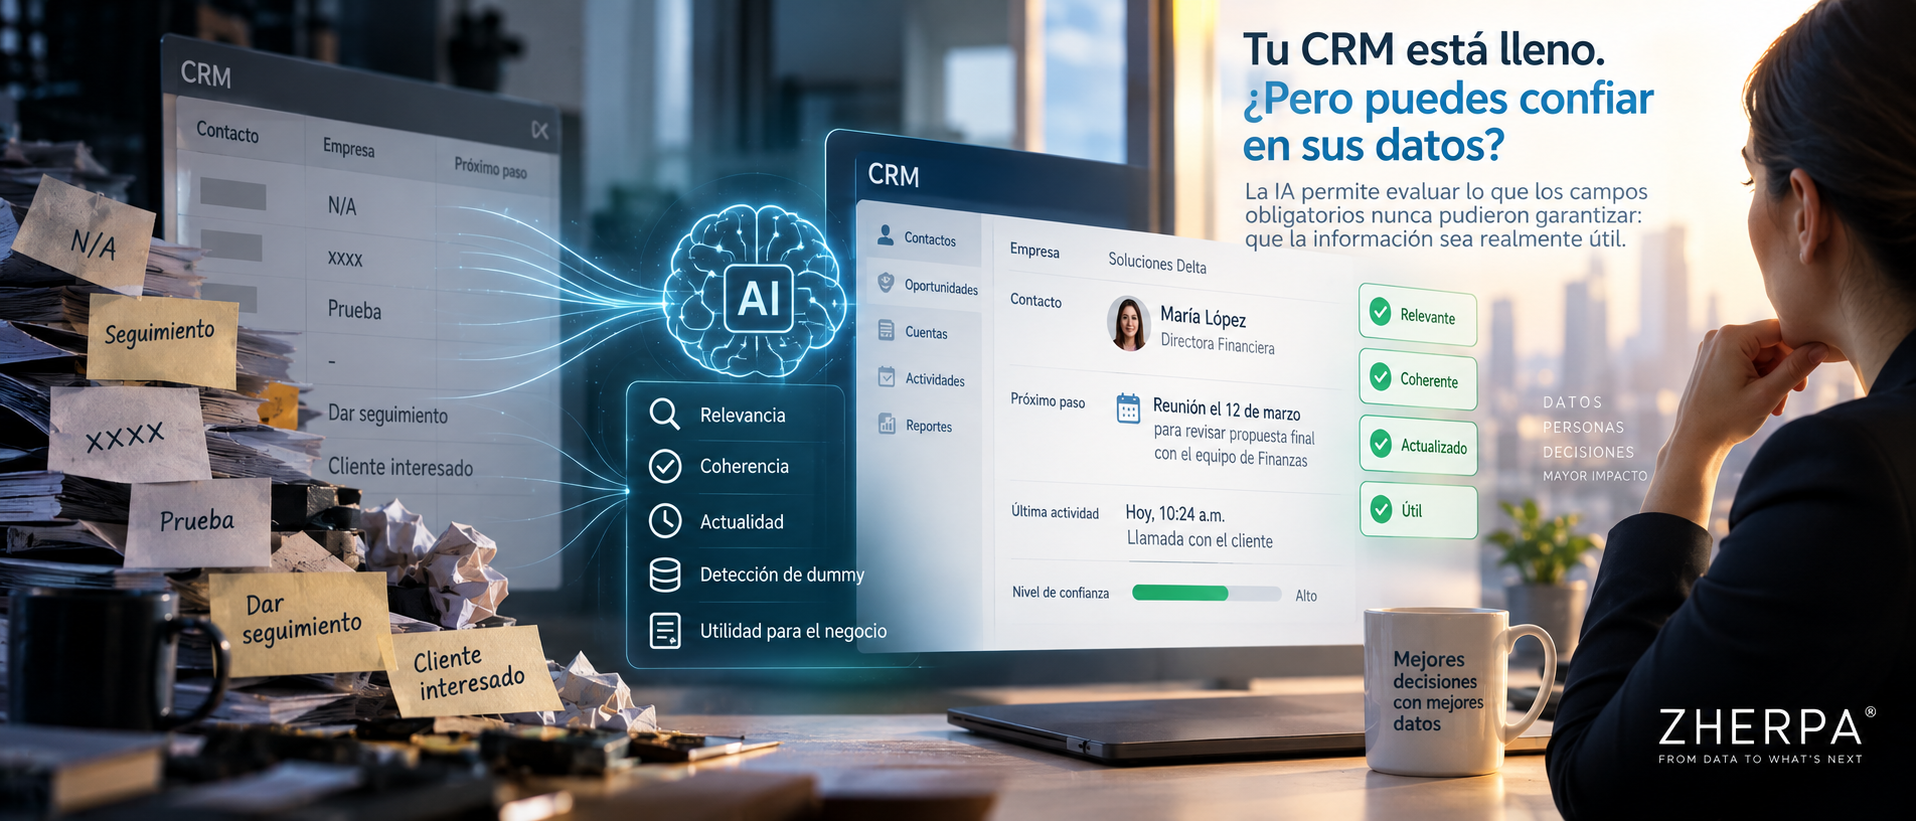
Imaginemos que un vendedor termina una conversación importante con un prospecto y quiere avanzar la oportunidad a la siguiente etapa. El CRM le exige completar el campo “Próximo paso”, así que escribe: “Dar seguimiento”.
El sistema acepta el registro. El campo ya no está vacío y, desde la perspectiva de completitud, el proceso funcionó exactamente como fue diseñado. Sin embargo, cuando otra persona abre esa oportunidad tres días después, sigue sin saber qué debe ocurrir, quién debe hacerlo, con quién, en qué fecha o con qué objetivo. El dato existe, pero su capacidad para sostener una acción o una decisión es mínima.
Ese pequeño ejemplo revela una limitación importante de la arquitectura tradicional del CRM: durante mucho tiempo hemos tenido mecanismos bastante buenos para determinar si existe un dato y si cumple determinadas reglas, pero mecanismos mucho más limitados para evaluar si el contenido significa realmente lo que el negocio necesita que signifique.
La inteligencia artificial generativa podría empezar a cerrar esa brecha. No porque pueda convertir automáticamente el CRM en una fuente de verdad, sino porque introduce una capacidad que las reglas convencionales tienen dificultades para reproducir: interpretar lenguaje y contexto para evaluar la calidad semántica de la información.
La pregunta de negocio, por tanto, no es simplemente si podemos utilizar IA para validar campos. Técnicamente podemos hacerlo. La cuestión más relevante es si esa capacidad mejora suficientemente la confiabilidad y utilidad del CRM como para justificar su costo, complejidad y riesgo, y en qué tipos de información tiene sentido utilizarla.
La respuesta, después de revisar la arquitectura disponible y sus limitaciones, es bastante más interesante que un simple sí o no.
Durante años medimos la presencia del dato porque era lo que podíamos controlar
La mayoría de los mecanismos tradicionales de validación funcionan especialmente bien cuando la empresa puede expresar con claridad una condición. Un correo electrónico debe respetar determinada estructura; una fecha no puede encontrarse fuera de cierto rango; un descuento no puede exceder la autorización correspondiente; un identificador debe seguir un patrón; un campo puede volverse obligatorio cuando una oportunidad entra en cierta etapa.
Estos controles continúan siendo valiosos y no existe una razón técnica sensata para sustituirlos indiscriminadamente con modelos generativos. Una regla que puede determinar con certeza que un descuento superior a 20% requiere otro tratamiento será normalmente más barata, rápida, explicable y predecible que preguntarle a un modelo de lenguaje si el descuento parece correcto.
Zoho CRM refleja bien esta lógica. Sus herramientas de Blueprint y reglas de diseño permiten hacer obligatorios determinados campos según el contexto del proceso y aplicar criterios de validación sobre los valores capturados. Fuente: Zoho CRM.
La dificultad aparece cuando la condición que queremos evaluar deja de ser matemática o estructural.
Consideremos nuevamente “Próximo paso”. Supongamos que tres vendedores escriben respectivamente: “Seguimiento.”, “Enviar propuesta.” y “Laura enviará el jueves la propuesta revisada a Carlos; después agendaremos una llamada para resolver las observaciones de Finanzas.”
Desde una perspectiva informática elemental, los tres registros contienen texto. Si la regla consiste únicamente en que el campo no esté vacío, los tres pueden ser igualmente válidos. Incluso podríamos imponer una longitud mínima y descubrir que el problema persiste, porque un usuario suficientemente decidido podría escribir una frase larga que continúe sin aportar información relevante.
Desde una perspectiva comercial, sin embargo, existe una diferencia sustancial. El tercer registro permite reconstruir qué ocurrirá, quién participará y por qué existe una siguiente acción. Esa información podría sostener continuidad entre vendedores, una revisión gerencial o incluso una automatización posterior. Los otros dos registros requieren interpretación adicional y, en el caso de “seguimiento”, prácticamente trasladan al futuro la misma incertidumbre que el campo pretendía eliminar.
Ésta es la frontera en la que la IA empieza a ser técnicamente interesante. No necesitamos que cuente caracteres ni que determine si el campo está vacío. Necesitamos que interprete si el contenido cumple el propósito empresarial para el cual ese campo existe.
El verdadero problema no es que falten datos, sino que confundimos completitud con confiabilidad
Esta distinción cambia considerablemente la conversación sobre calidad de CRM. Una organización puede alcanzar porcentajes extraordinariamente altos de completitud y conservar, al mismo tiempo, una base poco confiable para tomar decisiones.
Una oportunidad podría tener monto, fecha estimada de cierre, próximo paso, contacto, necesidad y probabilidad. El dashboard podría mostrar todos esos campos como completos. Sin embargo, si el próximo paso dice “seguimiento”, la fecha de cierre no ha sido modificada durante tres meses, el contacto dejó la empresa y la necesidad se resume como “mejorar procesos”, el registro está administrativamente completo pero comercialmente deteriorado.
En otras palabras, la existencia física de información en una base de datos no determina por sí sola su utilidad.
Esta diferencia se vuelve todavía más importante a medida que el CRM deja de ser únicamente un repositorio que consultan personas. Los productos actuales de Microsoft, por ejemplo, incorporan capacidades y agentes que trabajan con registros e información empresarial, mientras Customer Insights utiliza perfiles unificados que combinan distintas fuentes para proporcionar contexto. Fuente: Microsoft Learn.
Cuando una persona observa un dato mediocre, puede sospechar de él. Puede recordar una conversación, preguntarle a un compañero o decidir que la nota es demasiado vaga para utilizarla. Un sistema automatizado, en cambio, necesita alguna manera de distinguir entre un dato que simplemente existe y uno suficientemente confiable para el propósito de la acción que está a punto de realizar.
Por eso la discusión sobre calidad del CRM adquiere una nueva urgencia con la IA. Ya no se trata solamente de mantener una base ordenada. Se trata de determinar qué información puede convertirse responsablemente en insumo para otra inteligencia artificial.
Lo que la IA puede añadir es interpretación, no verdad
Aquí conviene establecer una frontera clara porque, de lo contrario, podemos sustituir un problema por otro.
Un modelo de lenguaje puede analizar “Dar seguimiento” y concluir razonablemente que la frase ofrece poca información accionable. Puede detectar que “xxxx”, “N/A”, “prueba” o una secuencia repetitiva parecen contenidos introducidos para superar una obligatoriedad. También puede comparar campos y señalar que una oportunidad cuya fecha de cierre es mañana resulta difícil de conciliar con una nota que indica que el cliente retomará la conversación dentro de tres meses.
En todos esos casos, la IA aporta una capacidad nueva: interpreta señales que serían difíciles de representar mediante cientos de reglas rígidas.
Pero interpretar una señal no equivale a demostrar un hecho.
Si el CRM registra que María López es directora financiera de una empresa, un modelo puede concluir que “Directora Financiera” es una respuesta plausible para el campo Cargo. Puede comprobar que no contradice otros datos disponibles e incluso evaluar si el resto de la conversación parece consistente con esa función. Nada de eso demuestra que María López siga ocupando ese cargo hoy.
Para establecer la vigencia del dato necesitamos contrastarlo con evidencia adecuada: una comunicación reciente, una fuente empresarial autorizada, información proporcionada por el propio cliente, otro sistema interno o una fuente externa pertinente.
La diferencia entre plausibilidad y verificación es crítica porque los propios modelos pueden equivocarse al trabajar con información estructurada. Una investigación publicada en ACL 2026 encontró errores de referencia de datos en todos los modelos evaluados, incluso cuando éstos comprendían la estructura de las tablas. Los investigadores también observaron que incorporar un mecanismo crítico específico para revisar las referencias podía mejorar la precisión de las respuestas hasta 12%. Fuente: ACL Anthology.
NIST aborda el problema desde otra perspectiva en su perfil de gestión de riesgos para IA generativa, que incorpora la confabulación entre los riesgos relevantes de estos sistemas y plantea la necesidad de gestionar explícitamente su confiabilidad. Fuente: NIST.
La consecuencia para un CRM es directa: una etiqueta como “Validado por IA” sería, por sí sola, conceptualmente pobre. No explicaría si el modelo determinó que el contenido era relevante, si encontró coherencia con otros campos, si contrastó una fuente externa o si simplemente no detectó nada sospechoso.
Una arquitectura más rigurosa debería comunicar qué aspecto de la calidad fue evaluado y con qué evidencia.
La arquitectura más prometedora no reemplaza las reglas: las organiza por capas
Si observamos el problema desde una perspectiva de arquitectura, empieza a aparecer un patrón mucho más razonable que enviar cada campo del CRM a un modelo generativo.
La primera capa continúa siendo la presencia. Si determinado proceso realmente necesita un dato para avanzar, la obligatoriedad sigue siendo una herramienta perfectamente válida.
La segunda capa corresponde a la validación determinística. Aquí permanecen formatos, rangos, catálogos, relaciones entre campos y condiciones que pueden expresarse de manera objetiva. Una fecha imposible, un porcentaje fuera de política o un identificador con estructura incorrecta no necesitan razonamiento generativo.
La tercera capa es donde la IA puede aportar una capacidad diferencial: la validación semántica. En ella ya no preguntamos únicamente si existe información, sino si la información responde realmente al propósito del campo, si tiene suficiente especificidad, si parece contenido dummy o si presenta contradicciones con el contexto disponible.
Una cuarta capa podría evaluar coherencia entre fuentes y eventos. Una oportunidad que supuestamente cerrará esta semana pero lleva noventa días sin actividad merece, al menos, una señal de atención. Una nota que afirma que la propuesta fue aprobada mientras otros registros indican que continúa en revisión puede justificar una comprobación adicional.
Finalmente, para determinados datos cuyo impacto lo amerite, aparece una quinta capa: el contraste con evidencia. En ese punto el sistema deja de preguntarse solamente si algo parece razonable y busca elementos que permitan sostener o refutar el dato.
Esta arquitectura tiene una ventaja importante: permite reservar la capacidad más costosa y probabilística para los casos en que realmente añade valor.
Microsoft ofrece un ejemplo útil, aunque no idéntico, en su arquitectura de referencia para deduplicación de contactos en Dynamics 365. Customer Insights utiliza reglas de deduplicación y matching para identificar candidatos; cuando existe un posible duplicado, un agente compara los valores de ambos registros y propone los mejores valores para la fusión, mientras el vendedor conserva la capacidad de corregir o aceptar la recomendación. La documentación, actualizada en abril de 2026, aclara que el caso funcional sigue siendo relevante aunque Microsoft recomienda patrones técnicos más recientes para nuevas implementaciones. Fuente: Microsoft Learn.
Más reveladora todavía es su consideración económica. Microsoft señala que Copilot Studio consume créditos y recomienda evitar invocaciones innecesarias; en este escenario, puede resultar preferible determinar primero mediante código si realmente existe un duplicado y llamar al componente generativo únicamente cuando haya algo que analizar.
Esa decisión contiene una regla de arquitectura que trasciende el caso de Microsoft: no utilizar IA para resolver aquello que una condición convencional puede resolver de manera más económica y confiable.
Un número telefónico y una nota comercial no tienen el mismo problema de calidad
Esta conclusión permite clasificar mejor los campos de un CRM.
Para un teléfono, un porcentaje de descuento, una moneda, una fecha o determinados identificadores, gran parte de la validación puede resolverse con reglas, catálogos, consultas o servicios especializados. Utilizar un LLM simplemente porque está disponible introduciría complejidad sin una ganancia proporcional.
En cambio, campos como “Necesidad del cliente”, “Próximo paso”, “Motivo de pérdida”, “Resumen de reunión”, “Riesgo de la oportunidad”, “Objeciones” o “Justificación del forecast” contienen lenguaje cuyo valor depende de significado, contexto y especificidad. Ahí la validación semántica puede empezar a justificar su costo.
Pensemos en “Motivo de pérdida”. Una empresa puede obligar al vendedor a seleccionar una opción de una lista, pero quizá “Precio” termine convirtiéndose en el cajón donde cae cualquier oportunidad difícil de explicar. Una IA con acceso al contexto autorizado podría detectar que las notas hablan repetidamente de tiempos de implementación, falta de una funcionalidad o ausencia de aprobación interna, aunque el registro final diga simplemente “Precio”.
Eso no significa que el modelo deba corregir automáticamente el motivo de pérdida. Significa que puede señalar una discrepancia y proporcionar evidencia para que la organización examine si su información comercial refleja realmente lo ocurrido.
La diferencia es importante porque el objetivo deja de ser vigilar al usuario y pasa a ser aumentar la calidad de la información que el negocio utilizará posteriormente.
El caso de negocio depende de cuánto cuesta el dato malo
Hasta este punto sabemos que técnicamente es posible incorporar una capa semántica. Todavía falta responder la parte más importante de la pregunta: ¿vale la pena?
La respuesta depende menos del precio unitario de una llamada a un modelo que del costo empresarial del error que pretendemos detectar.
Supongamos que una organización analiza miles o millones de actualizaciones de CRM. Incluso cuando cada inferencia individual sea barata, el costo acumulado incluye consumo del modelo, integraciones, almacenamiento de resultados, observabilidad, tratamiento de excepciones, privacidad, seguridad, mantenimiento y supervisión. Microsoft ya ofrece capacidades para estimar consumo de créditos de agentes a partir de demanda prevista, precisamente porque el volumen de actividad de IA se convierte en una variable de planificación económica. Fuente: Microsoft Learn.
Por eso la pregunta correcta no es cuánto cuesta “validar un campo con IA”, sino cuánto cuesta no detectar un dato deficiente antes de que sea utilizado.
Un número telefónico mal formateado puede ser barato de identificar mediante una regla. Una fecha de cierre sistemáticamente ficticia puede distorsionar un forecast completo. Un motivo de pérdida superficial puede contaminar el análisis de por qué la empresa pierde ventas. Una nota comercial sin contexto puede dificultar la continuidad cuando cambia el propietario de una cuenta. Un dato incorrecto sobre una persona puede propagarse a campañas, automatizaciones y agentes.
Los beneficios tampoco son uniformes. Si una empresa casi nunca utiliza determinado campo para análisis o decisiones, elevar su calidad probablemente tenga poco retorno. Si otro campo alimenta forecast, segmentación, automatización o decisiones de inversión comercial, una mejora relativamente pequeña en confiabilidad podría tener consecuencias económicas mucho mayores.
Así, la unidad de análisis adecuada no es “el CRM”, sino cada dato en relación con las decisiones y procesos que dependen de él.
Una implementación torpe podría empeorar precisamente el problema que intenta resolver
Existe además una dimensión humana que no debería quedar fuera de una investigación técnica.
Imaginemos que el vendedor escribe una nota después de una reunión y el sistema la rechaza porque considera que falta contexto. El vendedor la amplía, pero la IA solicita una fecha. Añade la fecha y aparece otra advertencia. Después de varios intentos consigue guardar el registro.
Quizá hayamos mejorado la calidad formal del dato, pero también hemos enseñado al usuario que el CRM es un obstáculo que debe superar.
Ese resultado sería especialmente problemático porque una parte importante de los datos deficientes surge de la fricción de captura. Añadir un “policía algorítmico” a cada campo podría producir usuarios más hábiles para satisfacer al modelo, no necesariamente información más confiable.
Por eso no toda detección debería convertirse en bloqueo. Dependiendo del impacto del dato, la IA podría sugerir una mejora durante la captura, permitir guardar y revisar posteriormente, generar una alerta cuando detecte una contradicción material o enviar ciertos casos a revisión humana. Sólo en escenarios donde el riesgo lo justifique tendría sentido impedir la continuación del proceso.
La calidad de información no debería optimizarse aislada de la experiencia de quien produce esa información.
El cambio más profundo sería dejar de tratar todos los datos llenos como igualmente confiables
Si esta arquitectura demuestra valor en la práctica, podría cambiar una suposición muy arraigada en los CRM: que una vez capturado y almacenado un dato, éste se convierte implícitamente en un hecho disponible para cualquier uso posterior.
Una arquitectura diferente podría asociar al dato información sobre su procedencia, antigüedad, coherencia, evidencia y nivel de confianza para determinados usos.
Una fecha de cierre actualizada hoy después de una reunión con el cliente no tendría necesariamente el mismo peso que una fecha heredada de una importación realizada hace seis meses. Un cargo confirmado mediante una fuente reciente no tendría la misma confianza que otro cuya procedencia se desconoce. Un próximo paso específico y consistente con la última actividad podría ser apto para disparar determinada automatización, mientras otro ambiguo requeriría intervención.
No se trata de llenar la interfaz con puntuaciones ni de convertir cada registro en un expediente forense. Se trata de que la arquitectura pueda distinguir internamente entre dato existente y dato suficientemente confiable para un uso determinado.
Esa distinción será más importante conforme los agentes de IA adquieran capacidad para ejecutar trabajo utilizando la información empresarial. Microsoft ya documenta agentes que crean, actualizan, resuelven y cierran casos, además de capacidades que utilizan datos empresariales para producir contexto y recomendaciones. Fuente: Microsoft Learn.
Cuando el sistema sólo mostraba el dato a un vendedor, la persona podía ejercer criterio. Cuando el dato empieza a disparar trabajo automatizado, su calidad se convierte también en un problema de control.
Entonces, ¿vale la pena utilizar IA para validar la información de un CRM?
La evidencia revisada no sostiene una recomendación de aplicar IA indiscriminadamente a todos los campos, pero sí permite identificar una frontera bastante clara.
Cuando el problema consiste en comprobar presencia, formato, rango o una condición objetiva, las reglas convencionales continúan siendo la primera opción lógica. Son más predecibles y, normalmente, más económicas.
Cuando el problema requiere interpretar lenguaje, evaluar relevancia, detectar contenido superficial o dummy, analizar especificidad o encontrar contradicciones contextuales, los modelos de IA abren una capacidad que antes era mucho más difícil de automatizar.
Cuando la pregunta es si un dato representa correctamente la realidad o continúa vigente, ni una regla ni la opinión de un LLM bastan por sí solas. Hace falta evidencia y, dependiendo del impacto, posiblemente revisión humana.
Por eso, la arquitectura que emerge de esta investigación no es “IA en lugar de validaciones”, sino una combinación de mecanismos especializados: reglas para aquello que puede definirse objetivamente, IA para aquello que necesita interpretación y fuentes de evidencia para aquello que debe comprobarse.
Desde la perspectiva económica, esa combinación sólo tiene sentido cuando la mejora de calidad afecta decisiones, procesos o automatizaciones cuyo valor justifique el costo adicional. La empresa debería comenzar precisamente por identificar esos puntos, en lugar de enviar indiscriminadamente todos sus datos a un modelo.
Quizá hemos estado haciendo la pregunta equivocada
La discusión comenzó preguntando si realmente sirve y vale la pena utilizar IA para comprobar que la información capturada en un CRM sea confiable.
La investigación conduce a una cuestión anterior: ¿por qué asumimos durante tanto tiempo que conseguir que un usuario llenara un campo era una aproximación suficiente a conseguir información de calidad?
El campo obligatorio solucionó un problema real. Evitó que información considerada necesaria quedara ausente. Sin embargo, al convertir una necesidad empresarial en una condición de software, también produjo una simplificación inevitable: “necesito saber qué ocurrirá después con esta oportunidad” terminó convertido en “este campo no puede quedar vacío”.
Durante años esa aproximación fue razonable porque era sencillo automatizar la segunda condición y difícil interpretar la primera.
La IA cambia esa frontera. Por primera vez resulta económicamente viable, en muchos escenarios, pedirle al sistema que no sólo compruebe si el usuario escribió algo, sino que evalúe si lo escrito parece cumplir el propósito empresarial para el que solicitamos esa información.
Eso no convierte a la inteligencia artificial en árbitro de la verdad ni elimina la necesidad de reglas, procesos, gobierno de datos y responsabilidad humana. Lo que hace es abrir una capa intermedia que antes resultaba costosa: la capacidad de evaluar significado y contexto a escala.
La consecuencia puede ser mucho más importante que tener un CRM “más limpio”. Conforme empresas y proveedores incorporan agentes capaces de consultar, recomendar y actuar sobre información empresarial, la pregunta deja de ser únicamente cuántos datos tenemos y pasa a ser cuáles de esos datos merecen suficiente confianza para permitir que una persona, una automatización o un agente actúe sobre ellos.
Un CRM lleno puede producir dashboards impecables y, aun así, describir mal la realidad comercial. Un CRM confiable debería aspirar a algo más difícil: que cada dato importante pueda demostrar por qué merece ser utilizado.
Y ésa, más que el simple hecho de añadir inteligencia artificial a un formulario, parece ser la oportunidad real.
Fuentes consultadas
- Zoho CRM — Blueprint
- Microsoft Learn — Customer Insights
- ACL 2026 — investigación sobre referencias de datos tabulares en LLM
- NIST — Generative AI Profile
- Microsoft Learn — Contact deduplication agent
- Microsoft Learn — estimación de créditos de IA
Investigación editorial de Zherpa. La evidencia y las limitaciones técnicas gobiernan las conclusiones; las capacidades concretas de cada plataforma pueden cambiar y deben verificarse antes de una implementación.
