
Laboratorio Zherpa / Investigación aplicada
Imaginemos una empresa del sector salud con aproximadamente 200 productos que llegan al paciente a través de una red de profesionales médicos.
El médico atiende al paciente, determina qué necesita y, cuando corresponde, prescribe o indica un producto. Esa decisión permite posteriormente al paciente acceder a aquello que el profesional ha seleccionado.
El modelo parece sencillo hasta que hacemos una pregunta:
¿Puede un médico recordar 200 productos, sus presentaciones, características, indicaciones, restricciones y documentación relevante cada vez que atiende a un paciente?
Probablemente ése sea el problema tecnológico interesante. No empezaríamos preguntando cómo vender más. Empezaríamos preguntando: ¿cómo reducimos la distancia entre lo que el médico necesita resolver y la información autorizada que necesita consultar para tomar su propia decisión?
Bienvenidos a este Laboratorio Zherpa.
El problema no es necesariamente el catálogo. Es recuperarlo en el momento adecuado.
Digitalizar 200 productos no es particularmente difícil. Podemos construir categorías, filtros, buscadores y fichas individuales. Pero eso sigue colocando buena parte del trabajo cognitivo sobre el usuario.
El profesional necesita recordar qué buscar. Después tiene que localizarlo, revisar información, regresar, comparar y finalmente decidir. A medida que aumenta el catálogo, también aumenta la posibilidad de que productos potencialmente relevantes no sean considerados simplemente porque el profesional no los recuerda en ese momento.
Aquí aparece una hipótesis que vale la pena probar:
¿Qué ocurriría si el profesional pudiera consultar los 200 productos utilizando lenguaje natural y recibir únicamente la información pertinente para revisar?
Eso ya no es solamente búsqueda. Es recuperación contextual de conocimiento.
De memorizar 200 productos a consultar una fuente de verdad
El objetivo no sería enseñar al modelo de IA a “memorizar” el catálogo. Haríamos exactamente lo contrario: el modelo debería saber consultarlo.
El modelo interpreta
Comprende la pregunta y el contexto proporcionado por el profesional.
El catálogo responde
Determina qué productos realmente existen y devuelve exclusivamente información autorizada.
Las reglas delimitan
Controlan qué información puede utilizarse, quién puede verla y qué acciones están permitidas.
El médico decide
Evalúa la información y conserva la responsabilidad sobre la decisión profesional.
Podemos resumirlo así: intención → recuperación → evidencia → revisión → decisión humana.
La IA no se convierte en la fuente de verdad. Se convierte en una interfaz para llegar a ella.
¿Cómo se vería en una consulta?
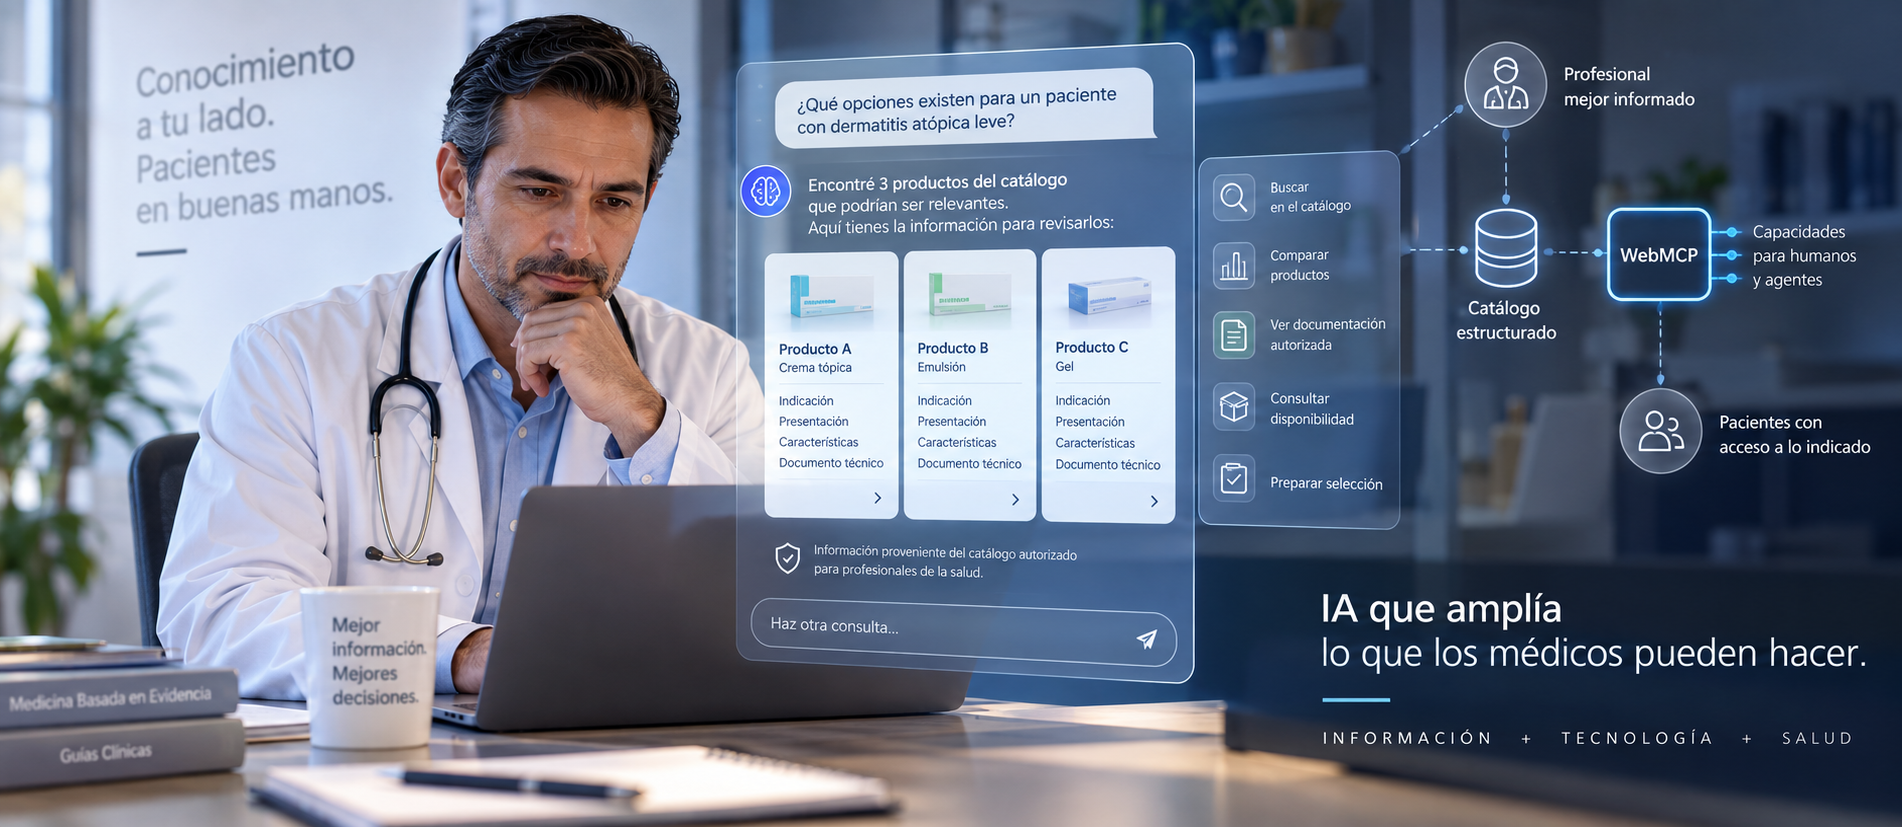
Supongamos que el profesional tiene acceso autorizado al catálogo. En lugar de navegar manualmente por categorías podría plantear una consulta relacionada con el caso que está atendiendo.
El agente analiza la solicitud y consulta el catálogo. De 200 productos podría recuperar únicamente aquellos que cumplan los criterios disponibles. Después podría organizar información como producto, presentación, composición publicada, indicaciones autorizadas, contraindicaciones y precauciones disponibles, documentación para profesionales, disponibilidad y otros datos autorizados relevantes para su revisión.
El médico puede entonces abrir las fuentes correspondientes, comparar información y tomar su propia decisión.
El cambio está en pasar de “recuerda cuál producto debes buscar” a “describe qué necesitas investigar y consulta la fuente autorizada”.
Una frontera crítica: recuperar no significa prescribir
Este laboratorio requiere una distinción fundamental. Un sistema que encuentra información relevante dentro de un catálogo no es equivalente a un sistema que decide qué tratamiento debe recibir una persona.
No diseñaríamos el agente para declarar: “Prescribe este medicamento.”
El objetivo inicial sería algo diferente: “Dentro de la fuente autorizada encontré estos productos relacionados con los criterios proporcionados. Ésta es la información disponible para que la revises.”
El agente ayuda a encontrar. El profesional interpreta. El profesional decide. Y, cuando existe una acción de prescripción, el profesional la autoriza.
En México esta separación tiene además una dimensión regulatoria. El Reglamento de la Ley General de Salud en Materia de Publicidad establece que la publicidad de medicamentos dirigida a profesionales de la salud sólo puede difundirse en medios orientados al sector y debe basarse en la información para prescribir medicamentos; también exige incorporar la clave del registro sanitario. Por eso la procedencia y gobierno de la información no serían detalles secundarios del sistema: serían parte de su arquitectura.
Primero construiríamos la fuente de verdad
Hablar de agentes, WebMCP o modelos de lenguaje antes de resolver los datos sería empezar por el extremo equivocado.
Antes de crear un asistente necesitamos estructurar aquello que puede consultar: identificación y presentación del producto, categoría, información autorizada, documentación, restricciones, disponibilidad, vigencia de la información, fuente y permisos.
No necesariamente todos los productos tendrían los mismos campos ni estarían sujetos a las mismas reglas. Un medicamento sujeto a prescripción, un dispositivo médico y otro producto del catálogo pueden requerir tratamientos regulatorios diferentes.
Después construiríamos el portal profesional
El siguiente componente sería una aplicación diseñada específicamente para el profesional. No sólo una tienda: un espacio donde pueda consultar el catálogo, buscar y filtrar, acceder a documentación autorizada, comparar información, guardar selecciones y preparar determinadas acciones.
La interfaz convencional seguiría siendo importante. La IA no elimina la necesidad de una buena aplicación. La complementa.
Después incorporamos IA
Con una fuente estructurada y un portal funcional, podemos introducir una interfaz conversacional. El agente tendría instrucciones específicas: interpretar la necesidad, consultar únicamente fuentes autorizadas, no inventar productos, no completar información ausente, diferenciar evidencia de inferencia, mostrar la procedencia de la información, solicitar datos adicionales cuando sean necesarios y dejar las decisiones clínicas al profesional.
Así la conversación deja de ser un chatbot genérico. Se convierte en una interfaz controlada hacia capacidades reales.
Y entonces WebMCP empieza a resultar interesante
La especificación WebMCP define una interfaz JavaScript para que aplicaciones web expongan funcionalidad como herramientas con descripciones en lenguaje natural y esquemas estructurados que pueden ser invocados por agentes. También plantea flujos colaborativos donde usuario y agente trabajan dentro de la misma interfaz conservando contexto y control del usuario.
En nuestro laboratorio podríamos experimentar con herramientas hipotéticas como:
search_catalogget_product_informationcompare_productsget_authorized_documentationcheck_availabilityprepare_selectionprepare_prescription_draft
Estos nombres no describen herramientas actualmente implementadas en una empresa del sector salud. Representan funciones que podríamos investigar.
¿Por qué WebMCP si ya tenemos una API?
Porque resuelven problemas relacionados, pero no idénticos. Una API puede conectar sistemas. WebMCP permite que una aplicación web declare capacidades que un agente compatible puede descubrir y utilizar dentro del contexto de la experiencia web.
La documentación actual de Chrome describe este patrón mediante document.modelContext: el sitio registra herramientas, un agente autorizado puede descubrirlas y puede ejecutarlas con argumentos estructurados.
Eso permite pensar en algo más amplio que “el chatbot de la empresa”. En el futuro, el médico podría llegar con su propio agente y la aplicación podría indicarle qué puede consultar, qué parámetros necesita, qué acciones están permitidas y cuáles requieren intervención humana.
El agente del médico podría hablar con las capacidades del negocio
Imaginemos que el médico utiliza un agente compatible y le dice: “Necesito revisar qué alternativas existen en este catálogo para el caso que estoy atendiendo.”
El agente descubre que la aplicación ofrece search_catalog, envía criterios estructurados y la aplicación consulta su propia fuente de verdad. Si después el médico pide comparar tres opciones, el agente podría utilizar compare_products y construir la comparación con información proveniente del sistema autorizado.
Finalmente, una función como prepare_prescription_draft podría preparar trabajo, pero no ejecutar la decisión clínica.
Preparar no significa autorizar
Una arquitectura conservadora podría devolver un estado como awaiting_physician_confirmation.
El agente hizo el trabajo preparatorio. No ejecutó la decisión clínica. El médico revisa, modifica, descarta o solicita más evidencia y únicamente después de una acción explícita se produce el siguiente efecto.
IA explora → IA recupera → IA compara → IA prepara → médico decide → médico autoriza.
¿Y qué ocurre después de la decisión del médico?
Aquí aparece una segunda oportunidad tecnológica. La prescripción o indicación autorizada podría convertirse, sujeto al marco legal y operativo aplicable, en una llave para el recorrido del paciente:
decisión profesional → autorización → identificación válida → catálogo permitido → compra.
El paciente no necesitaría explorar 200 productos. Podría entrar a una experiencia donde aparecen exclusivamente aquellos productos que puede adquirir conforme a la autorización y las reglas aplicables.
Por eso nuestra hipótesis inicial sería que el mayor valor agentivo podría estar del lado del profesional, no necesariamente del paciente.
El paciente quizá no necesite un agente
No todos los procesos necesitan IA. Si el paciente recibe una autorización que determina claramente qué puede adquirir, una interfaz convencional podría resolver perfectamente el proceso: validar → revisar → pagar → recibir.
Agregar un agente sólo porque podemos hacerlo introduciría complejidad innecesaria. El médico enfrenta otro problema: necesita encontrar conocimiento dentro de un universo considerable de posibilidades.
200 productos hacen visible el problema
Con cinco productos probablemente no construiríamos este sistema. Con veinte, quizá un buen buscador sería suficiente. Con 200 empiezan a aparecer preguntas interesantes.
¿Cuántos recuerda habitualmente cada profesional? ¿Cuánto tarda en encontrar información? ¿Qué porcentaje del catálogo prácticamente nunca consulta? ¿Cuántas veces necesita buscar documentación adicional? ¿Cuántas opciones relevantes quedan fuera de consideración porque no fueron recordadas?
No conocemos todavía las respuestas. Y precisamente por eso son métricas de laboratorio.
Hipótesis: un sistema de recuperación asistido por IA puede reducir el esfuerzo necesario para encontrar y revisar información autorizada dentro de un catálogo profesional extenso.
¿Qué mediríamos?
Tiempo hasta información relevante. ¿Cuánto tarda el profesional en llegar a las fichas que necesita?
Cobertura del catálogo. ¿Qué porcentaje del catálogo es realmente descubierto y consultado?
Precisión de recuperación. ¿Los productos recuperados corresponden a los criterios solicitados?
Trazabilidad. ¿Podemos identificar de dónde provino cada afirmación presentada?
Correcciones. ¿Con qué frecuencia el profesional corrige o descarta los resultados del agente?
Incidentes. ¿El sistema presentó información que no debía, desactualizada o fuera de contexto?
Adopción. ¿Los profesionales prefieren la consulta asistida o continúan utilizando navegación tradicional?
Sólo después incorporaríamos métricas comerciales. Primero necesitamos comprobar que la capacidad funciona correctamente.
Un riesgo que no podemos ignorar: prompt injection
Convertir una aplicación en un conjunto de herramientas operables por agentes también crea nuevos riesgos. La documentación de seguridad de Chrome para WebMCP advierte específicamente sobre indirect prompt injection: contenido malicioso puede intentar influir en las instrucciones que recibe un modelo.
En salud esto exige una arquitectura especialmente conservadora. No deberíamos confiar solamente en que el modelo “se comporte bien”. Necesitamos permisos, separación de fuentes, validación de parámetros, registros, límites de herramientas y confirmaciones humanas para las acciones correspondientes.
Tampoco mezclaríamos la recuperación clínica con incentivos comerciales
Supongamos que el modelo empresarial incluye algún mecanismo de atribución, compensación o relación comercial con profesionales. Ese componente requiere análisis jurídico, regulatorio y ético específico antes de implementarse.
Arquitectónicamente estableceríamos desde el principio una separación:
información profesional → decisión clínica → prescripción o indicación → transacción → atribución comercial.
La remuneración nunca debería convertirse en una variable que haga que el agente coloque determinado producto por encima de otro cuando está asistiendo una consulta profesional.
No necesitamos esperar a que WebMCP madure
Podríamos comenzar a construir este sistema sin WebMCP: catálogo estructurado, portal profesional, búsqueda semántica, recuperación basada en fuentes autorizadas, permisos, trazabilidad y confirmación humana.
Posteriormente podemos exponer determinadas funciones como herramientas WebMCP. Esto reduce el riesgo tecnológico: si WebMCP evoluciona, cambia o tarda en alcanzar adopción amplia, los activos fundamentales permanecen.
Porque WebMCP todavía está evolucionando
A septiembre de 2026, WebMCP sigue siendo una tecnología emergente. La especificación publicada el 17 de septiembre de 2026 es un Draft Community Group Report y declara expresamente que no es un estándar W3C ni forma parte del Standards Track.
Chrome mantiene documentación de la API, un Origin Trial y un Intent to Experiment, y señala que WebMCP continúa en discusión activa y puede cambiar.
Esto no significa que debamos ignorarlo. Significa que debemos experimentar de forma que el negocio no dependa completamente de su adopción.
La arquitectura que probaríamos
- Fuente de verdad: productos + documentación autorizada + reglas + vigencia + permisos.
- Portal profesional: identidad + búsqueda + fichas + documentación + historial.
- Recuperación inteligente: lenguaje natural → consulta estructurada → resultados verificables.
- Herramientas: buscar → recuperar → comparar → validar → preparar.
- WebMCP: exposición controlada de determinadas herramientas a agentes compatibles.
- Gobierno humano: el profesional revisa y conserva las decisiones de mayor impacto.
- Transacción: el paciente accede posteriormente al proceso que corresponda conforme a la autorización y reglas aplicables.
La tecnología amplía la capacidad del profesional. No sustituye su responsabilidad.
El activo no es el chatbot
El activo que estamos construyendo no es una conversación bonita con inteligencia artificial. Es un catálogo que puede ser consultado, comprendido y operado de forma estructurada.
Los datos son un activo. Las reglas son un activo. La documentación autorizada es un activo. Las herramientas son un activo. La trazabilidad es un activo.
La interfaz conversacional es solamente una de las formas de acceder a ellos. Y WebMCP podría convertirse en otra.
Del catálogo digital al catálogo agentivo
Durante décadas hemos organizado información para que una persona pueda navegarla: categorías, menús, buscadores, filtros y fichas.
La aparición de agentes introduce otra posibilidad. Podemos mantener todas esas interfaces para humanos y, al mismo tiempo, preparar determinadas capacidades para que sean entendidas y utilizadas por agentes.
Cuando el catálogo contiene cientos de productos, esto puede resultar especialmente interesante. El profesional ya no necesita recordar dónde vive cada pieza de información. Puede expresar qué necesita investigar. El agente puede localizarla. El sistema puede demostrar de dónde provino. Y el humano puede decidir.
Cuando el conocimiento disponible supera lo que una persona puede recordar fácilmente, el valor de la IA no necesariamente está en decidir por ella. Puede estar en hacer accesible, en el momento adecuado, aquello que necesita para decidir mejor.
Y si además esa fuente de verdad puede exponer funciones estructuradas a agentes, empezamos a pasar de un catálogo diseñado únicamente para ser navegado a un catálogo preparado para ser operado por humanos y agentes bajo reglas explícitas.
Ahí es donde WebMCP merece nuestra atención.
Alcance del Laboratorio Zherpa
Este Laboratorio Zherpa utiliza un escenario empresarial compuesto y anonimizado con fines de investigación. No describe la operación, tecnología, catálogo, relaciones comerciales ni procesos de prescripción de una empresa o cliente específico.
Las herramientas WebMCP mencionadas son diseños hipotéticos para analizar la arquitectura propuesta. Cualquier implementación real en salud requeriría revisión clínica, regulatoria, jurídica, de privacidad y seguridad específica antes de desplegarse.
Fuentes
- Web Machine Learning Community Group — WebMCP Specification, Draft Community Group Report, 17 de septiembre de 2026.
- Chrome for Developers — WebMCP Imperative API, actualización del 11 de septiembre de 2026.
- Chrome for Developers — WebMCP Tool Security, actualización del 1 de septiembre de 2026.
- Cámara de Diputados — Reglamento de la Ley General de Salud en Materia de Publicidad, artículos 40–42.
